Una interrupción eléctrica en Londres dejó sin servicio parte de la infraestructura de Google Cloud. El incidente permite entender qué puede fallar incluso cuando existen equipos de emergencia y cómo preparar una empresa para la caída de un proveedor.
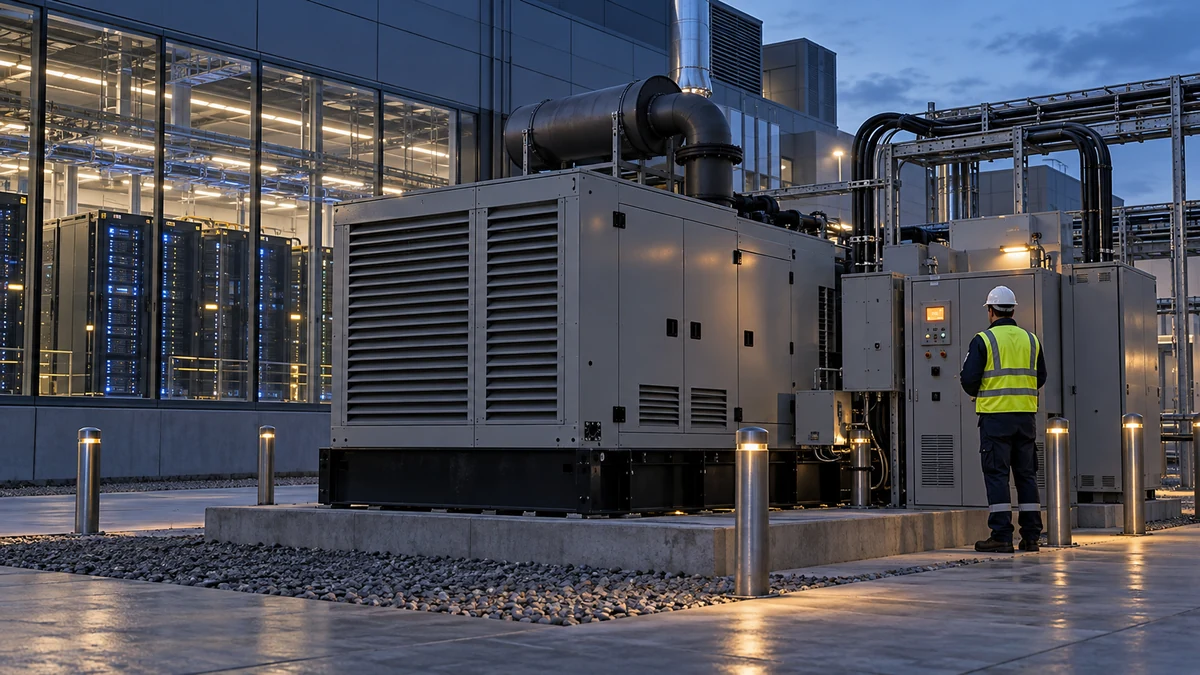
En un centro de datos, disponer de generadores debería permitir que los servidores sigan funcionando cuando se corta la electricidad. Pero entre detectar el apagón y arrancar esos equipos hay una cadena de decisiones automáticas. Si esa cadena interpreta mal lo que está ocurriendo, el respaldo puede quedarse esperando mientras se agota la energía disponible.
Eso ocurrió el 20 de octubre de 2026 en una instalación que alojaba una zona de Google Cloud en Londres. Según el informe del incidente publicado el 27 de octubre, un corte eléctrico externo y un fallo en la lógica de control impidieron el arranque automático de los generadores. El impacto principal sobre los servicios duró seis horas y ocho minutos.
El caso plantea una cuestión que también afecta a organizaciones mucho más pequeñas: qué ocurre con su actividad cuando una aplicación esencial deja de responder. Desde ITO, proponemos examinar esa dependencia a partir del trabajo que necesita continuar: atender a un cliente, consultar existencias o confirmar un pedido.
El sistema detectaba electricidad donde ya no podía aprovecharla
Una de las dos vías de suministro estaba desconectada por mantenimiento. Sin embargo, el control seguía detectando tensión antes del interruptor que la aislaba e interpretaba que había una fuente disponible. Cuando falló la otra vía, no ordenó arrancar los generadores. Las baterías sostuvieron temporalmente la carga, hasta agotarse.
La interrupción también tuvo efectos fuera de la zona afectada: al desviar trabajo hacia otras zonas, aparecieron errores y retrasos. Esta secuencia, descrita por Google, muestra cómo una incidencia localizada puede repercutir en servicios que dependen de varios componentes.
Para una empresa usuaria, la enseñanza práctica consiste en mirar las conexiones entre sus recursos. Podemos imaginar dos canales de atención que utilizan el mismo sistema para identificar al cliente: aunque uno sea telefónico y otro digital, ambos pueden quedar limitados si ese sistema falla. La aparente diversidad de herramientas no dice, por sí sola, cuánto trabajo podrá mantenerse.
La dependencia puede estar detrás de la aplicación que contratamos
Imaginemos una distribuidora que utiliza un programa en línea para registrar pedidos, consultar el almacén y preparar las rutas. Una mañana el programa deja de funcionar. La oficina conserva electricidad e internet, pero el personal no puede confirmar qué mercancía está reservada ni qué entregas se han comprometido. Es un ejemplo hipotético de cómo una incidencia externa puede convertirse en un problema operativo interno.
En ese escenario, resultaría útil saber quién presta cada parte del servicio. La distribuidora quizá haya contratado el programa a un proveedor local, mientras que este aloja sus aplicaciones y datos en una plataforma de terceros. Preguntar por esa cadena permitiría entender qué incidencias puede resolver directamente el proveedor y cuáles requieren que intervenga otra organización.
La revisión debería llegar hasta las tareas concretas. ¿Se pueden consultar los pedidos ya confirmados? ¿Existe una forma autorizada de registrar nuevas solicitudes? ¿Quién informa de los cambios de plazo? Estas preguntas ayudan a describir una alternativa de trabajo antes de discutir qué tecnología comprar. También permiten detectar si la información necesaria para activar esa alternativa solo está disponible dentro del sistema averiado.
La infraestructura física que sostiene estas herramientas suele pasar inadvertida durante el uso cotidiano. Como explicamos al analizar la refrigeración de los centros de datos, la computación depende de instalaciones y recursos materiales. Conocer esa dependencia ayuda a evaluar el servicio más allá de las funciones que aparecen en su pantalla.
Recuperar los datos y recuperar la actividad son objetivos distintos
La guía de recuperación ante desastres de Google Cloud propone definir cuánto tiempo puede permanecer una aplicación fuera de servicio y qué intervalo de datos sería aceptable perder. Son dos medidas diferentes: el objetivo de tiempo de recuperación, conocido como RTO, y el objetivo de punto de recuperación, o RPO. Establecerlos exige valorar el impacto sobre el negocio.
Supongamos que la distribuidora guarda una copia de sus datos cada noche. Esa copia podría ayudar a reconstruir información, pero no resolvería por sí sola cómo trabajar durante la mañana ni qué hacer con los pedidos posteriores a la última copia. En este ejemplo habría que decidir dónde recuperar el programa, quién puede hacerlo y cómo comprobar las operaciones que todavía no aparecen en el respaldo.
La respuesta tampoco tiene por qué ser idéntica para todas las herramientas. Como criterio de gestión, proponemos comparar el efecto de una interrupción en cada proceso: un informe interno que puede esperar tiene una urgencia diferente a la confirmación de una expedición que sale en una hora. Esa comparación permitiría asignar recursos de continuidad donde el retraso produce un perjuicio mayor.
La documentación de Google señala que exigir recuperaciones más rápidas y menores pérdidas de datos suele aumentar el coste y la complejidad. Por eso conviene acordar objetivos que puedan comprobarse. Una promesa genérica de disponibilidad ofrece menos información para decidir que una explicación del procedimiento de recuperación, sus condiciones y los resultados de la última prueba.
El respaldo necesita una prueba que incluya a quienes lo utilizarán
El marco de fiabilidad de Google Cloud combina redundancia, observación del sistema, recuperación y aprendizaje tras los fallos. También contempla mantener funciones limitadas cuando no es posible ofrecer el servicio completo. La fiabilidad se plantea como una responsabilidad compartida entre equipos técnicos y áreas de negocio.
En la distribuidora del ejemplo, propondríamos ensayar una interrupción controlada sin comprometer la operación real. El personal podría comprobar si localiza la información autorizada, registra una solicitud provisional y sabe a quién comunicar una incidencia. El ejercicio debería terminar al reincorporar ese trabajo al sistema, porque volver a acceder a la aplicación no garantiza que todos los pedidos estén correctamente registrados.
Ese ensayo permitiría encontrar detalles que una revisión técnica podría pasar por alto. Quizá solo una persona conozca el procedimiento, las instrucciones estén guardadas en la aplicación que se simula como inaccesible o dos departamentos utilicen numeraciones incompatibles. Son posibilidades que conviene comprobar, no fallos que debamos dar por existentes en cualquier empresa.
La incorporación de automatizaciones y asistentes de IA merece la misma revisión. Al plantearse cómo evaluar la fiabilidad de una inteligencia artificial, también interesa considerar qué tarea queda pendiente si el sistema no está disponible. Nuestra recomendación es definir quién puede retomarla y qué información necesita, especialmente cuando hay compromisos con clientes.
Para la distribuidora, una prueba útil terminaría con un pedido provisional incorporado sin duplicidades, una entrega revisada y un cliente informado. Ese resultado permitiría saber qué parte del negocio puede seguir funcionando y qué necesita mejorar. Es una comprobación más cercana a la realidad del equipo que limitarse a preguntar si el proveedor dispone de un sistema de emergencia.
Redacción ITO · International Technological Observatory